O AGENTICO
Nvidia lança modelos Nemotron Bolt para dispositivos locais
5 fontesdesde 15 de outubro de 20265 artigos
A Nvidia lançou dois modelos Nemotron Bolt voltados a cargas de trabalho locais e de borda. O Bolt 74B-A9B, com suporte a 24 GB de memória, está disponível; o Bolt E4B, projetado para 4 GB, tem lançamento previsto para 23 de outubro.
Resumo
A Nvidia lançou o modelo multimodal aberto Nemotron 3.5 Super VL para agentes empresariais.
O lançamento é o principal acontecimento relatado e apresenta um modelo destinado a automatizar tarefas em empresas.
O Nemotron 3.5 Super VL tem 120 bilhões de parâmetros e ativa 12 bilhões por token em sua arquitetura de mistura de especialistas.
A arquitetura combina grande capacidade total com a ativação de uma parcela menor dos parâmetros durante cada processamento.
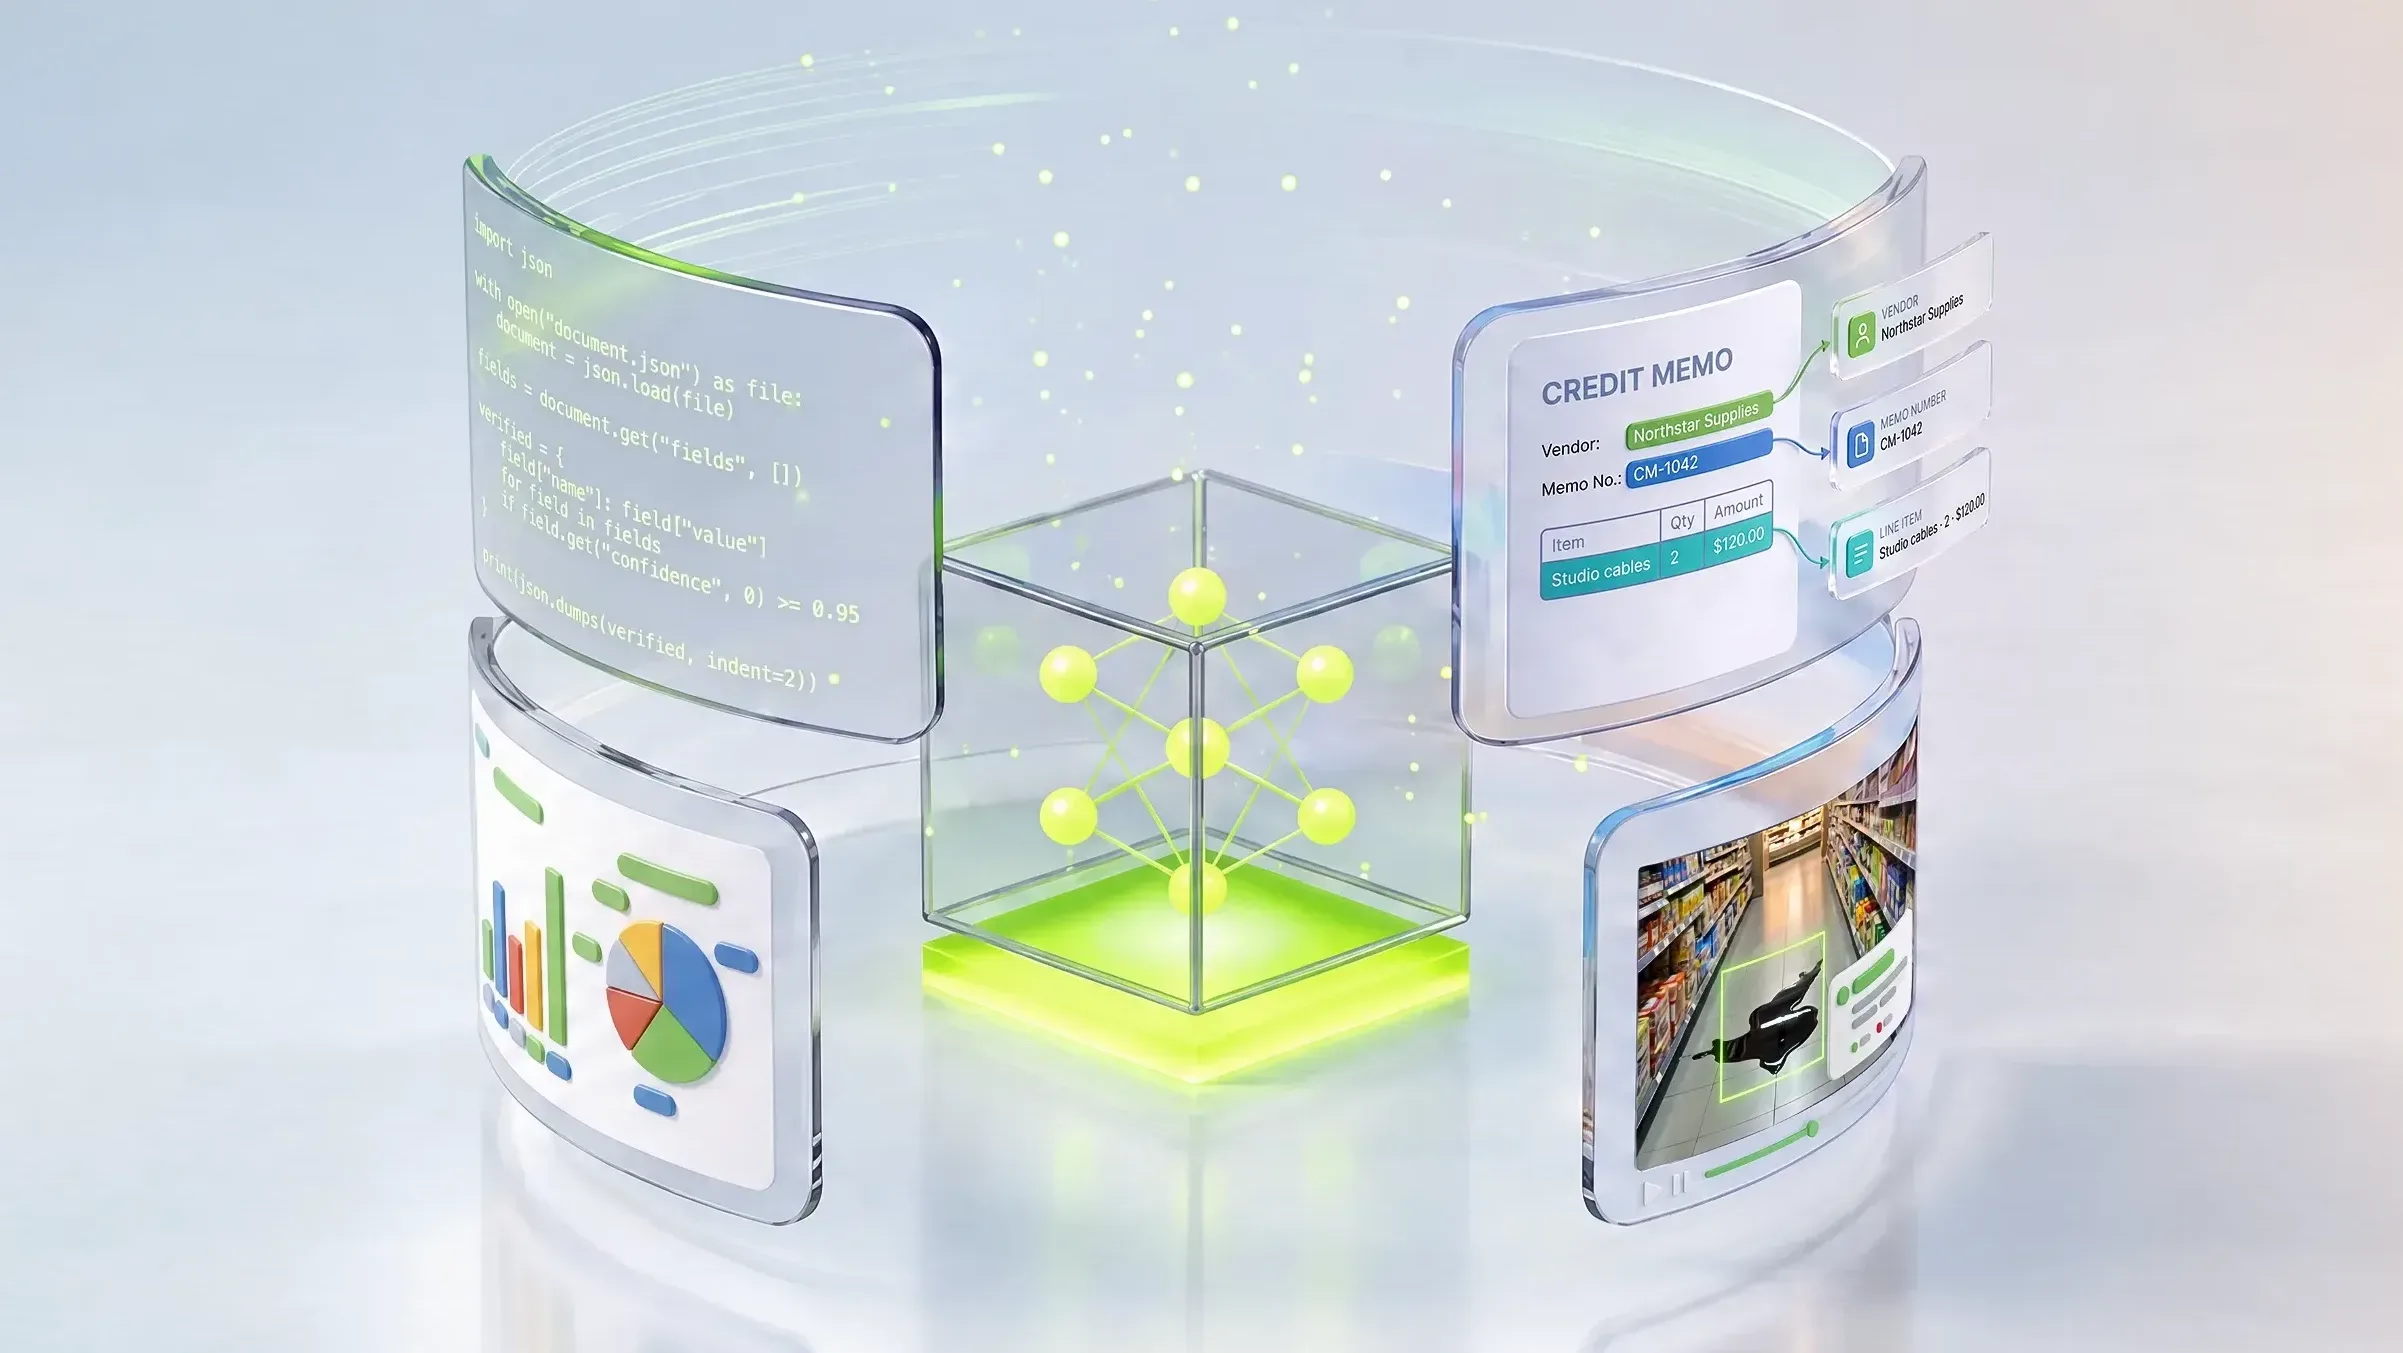
O modelo combina compreensão de texto, imagens, documentos e vídeos com raciocínio, seguimento de instruções e uso de ferramentas.
Essas capacidades permitem que agentes empresariais lidem com diferentes tipos de informação e executem tarefas com ferramentas.
A Nvidia desenvolveu o modelo com a Nemotron Coalition, que inclui Mistral AI, Thinking Machines Lab, Perplexity e Black Forest Labs.
A participação do grupo indica que o desenvolvimento envolveu outras organizações além da Nvidia.
A Nvidia lançou os modelos Nemotron 3.5 Bolt 74B-A9B 24GB e Bolt E4B 4GB para dispositivos locais e de borda.
As variantes ampliam a família Nemotron para equipamentos menores, além dos servidores empresariais.
O Nemotron 3.5 Bolt 74B-A9B 24GB está disponível, enquanto o Bolt E4B 4GB tem lançamento previsto para 23 de outubro.
As datas indicam quando cada variante pode ser adotada pelos usuários.
A Nvidia afirma que o Nemotron 3.5 Super VL oferece até cinco vezes mais throughput em tarefas agênticas em uma única GPU do que outros modelos abertos de sua categoria de tamanho.
A comparação destaca a eficiência de processamento que a Nvidia atribui ao modelo.
A Nvidia diz que treinou o Nemotron 3.5 Super VL com cerca de 26 trilhões de tokens em pré-treinamento e pré-treinamento continuado.
A escala de dados de treinamento ajuda a dimensionar o processo de desenvolvimento do modelo.
Todo dia, só o que dois veículos independentes confirmaram — no seu feed.