O AGENTICO
Pesquisadores encolhem modelo de IA e o tornam mais inteligente
2 fontesdesde 25 de agosto de 20262 artigos
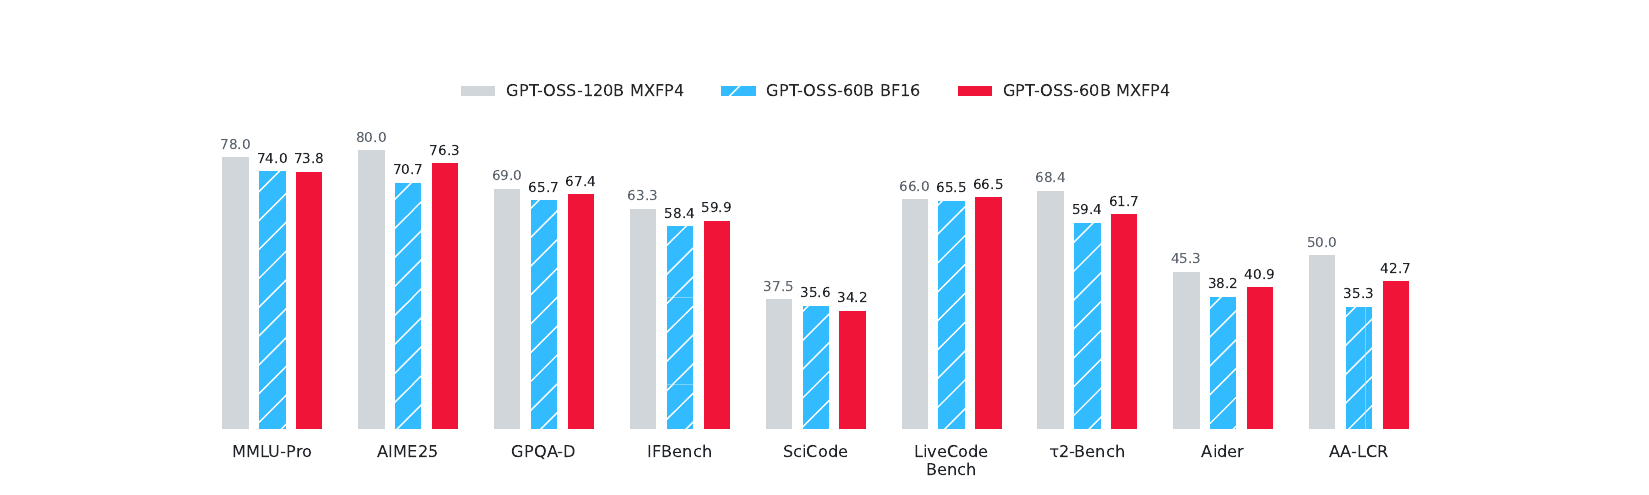
A equipe da Multiverse Computing publicou um método chamado Quantization-Aware Healing (QAH) que, aplicado a um modelo GPT-OSS de 120B parâmetros comprimido para 60B com quantização MXFP4, produziu uma versão menor, mais barata e mais precisa que o original em 7 de 9 benchmarks. O QAH se destaca por usar a versão original inteligente como professor durante o treinamento, em vez de uma versão intermediária fraca.
Resumo
O método Quantization-Aware Healing foi aplicado a um modelo GPT-OSS de 120B parâmetros comprimido para 60B, com quantização MXFP4 de 4 bits.
Detalha a técnica e o modelo específico usados no experimento, mostrando a escala da compressão.
A versão comprimida superou o modelo original em precisão em 7 de 9 benchmarks, sendo menor, mais barata e mais precisa.
Mostra o resultado contraintuitivo: o modelo menor e comprimido é superior, o que pode influenciar práticas futuras de compressão de IA.
O método se destaca por ensinar o modelo comprimido a partir da versão original inteligente, e não da versão intermediária fraca.
Explica a contribuição central do método, que melhora a eficiência do processo de compressão.
O método Quantization-Aware Healing foi publicado no blog do Hugging Face em 25 de agosto pela equipe da Multiverse Computing.
A publicação em um canal oficial de uma plataforma de IA valida a divulgação do método para a comunidade técnica.
Os pesquisadores afirmam que, em um pipeline de cura baseado em destilação, o passo de quantização não é um custo a ser minimizado, mas uma oportunidade adicional para supervisão do professor, produzindo um modelo ao mesmo tempo mais barato, mais leve e pelo menos tão preciso quanto sua versão em precisão total.
Essa é uma mudança conceitual importante: trata a quantização como benefício no treinamento, não como perda a corrigir.
A equipe da Multiverse Computing publicou um método chamado Quantization-Aware Healing (QAH) no blog do Hugging Face em 25 de agosto.
Estabelece a autoria e a data da publicação do método.
O QAH foi aplicado a um modelo GPT-OSS de 120B parâmetros, comprimido para 60B com quantização MXFP4 de 4 bits.
Descreve a aplicação prática do método e as especificações técnicas do modelo.
Dados
- Parâmetros do modelo GPT-OSS original
- 120B parâmetros
- Parâmetros do modelo GPT-OSS comprimido
- 60B
- Bits da quantização MXFP4
- 4 bits
- Benchmarks em que o modelo comprimido superou o original
- 7
- Total de benchmarks avaliados
- 9
- Data de publicação do método Quantization-Aware Healing
- 25 de agosto
- Data de publicação do método QAH
- 25 de agosto
- Parâmetros do modelo GPT-OSS original
- 120B parâmetros
- Parâmetros do modelo após a compressão
- 60B
- Precisão da quantização MXFP4
- 4 bits
Citações
“The 4-bit model ends up smaller, cheaper to run, and more accurate than the checkpoint it was quantized from.”
Mostra o resultado contraintuitivo: o modelo menor e comprimido é superior, o que pode influenciar práticas futuras de compressão de IA.
— Multiverse Computing, autores do estudo · ver em Hugging Face Blog ↗
“The dominant healing recipe is quantization-aware training (QAT). It inserts fake-quantization operators into the forward pass and keeps fine-tuning the model on a task loss, so the weights learn to tolerate the low-precision representation.”
Explica a contribuição central do método, que melhora a eficiência do processo de compressão.
— Multiverse Computing, autores do estudo · ver em Hugging Face Blog ↗
“the quantization step is not a cost to be minimized but an additional opportunity for teacher supervision, yielding a model that is simultaneously cheaper to serve, lighter in memory, and at least as accurate as its full-precision counterpart”
Essa é uma mudança conceitual importante: trata a quantização como benefício no treinamento, não como perda a corrigir.
— Pesquisadores da Multiverse Computing, autores do artigo · ver em Decrypt ↗
“Multiverse Computing's team published a method called Quantization-Aware Healing on the Hugging Face blog on August 25.”
Estabelece a autoria e a data da publicação do método.
— Multiverse Computing, autores do estudo · ver em Decrypt ↗
“We introduce Quantization-Aware Healing (QAH), and applied to a GPT-OSS 120B model compressed to 60B parameters and quantized to MXFP4, it produces a model that beats its own full-precision (bfloat16) version on 7 of 9 benchmarks.”
Descreve a aplicação prática do método e as especificações técnicas do modelo.
— Multiverse Computing, autores do estudo · ver em Hugging Face Blog ↗
Todo dia, só o que dois veículos independentes confirmaram — no seu feed.